
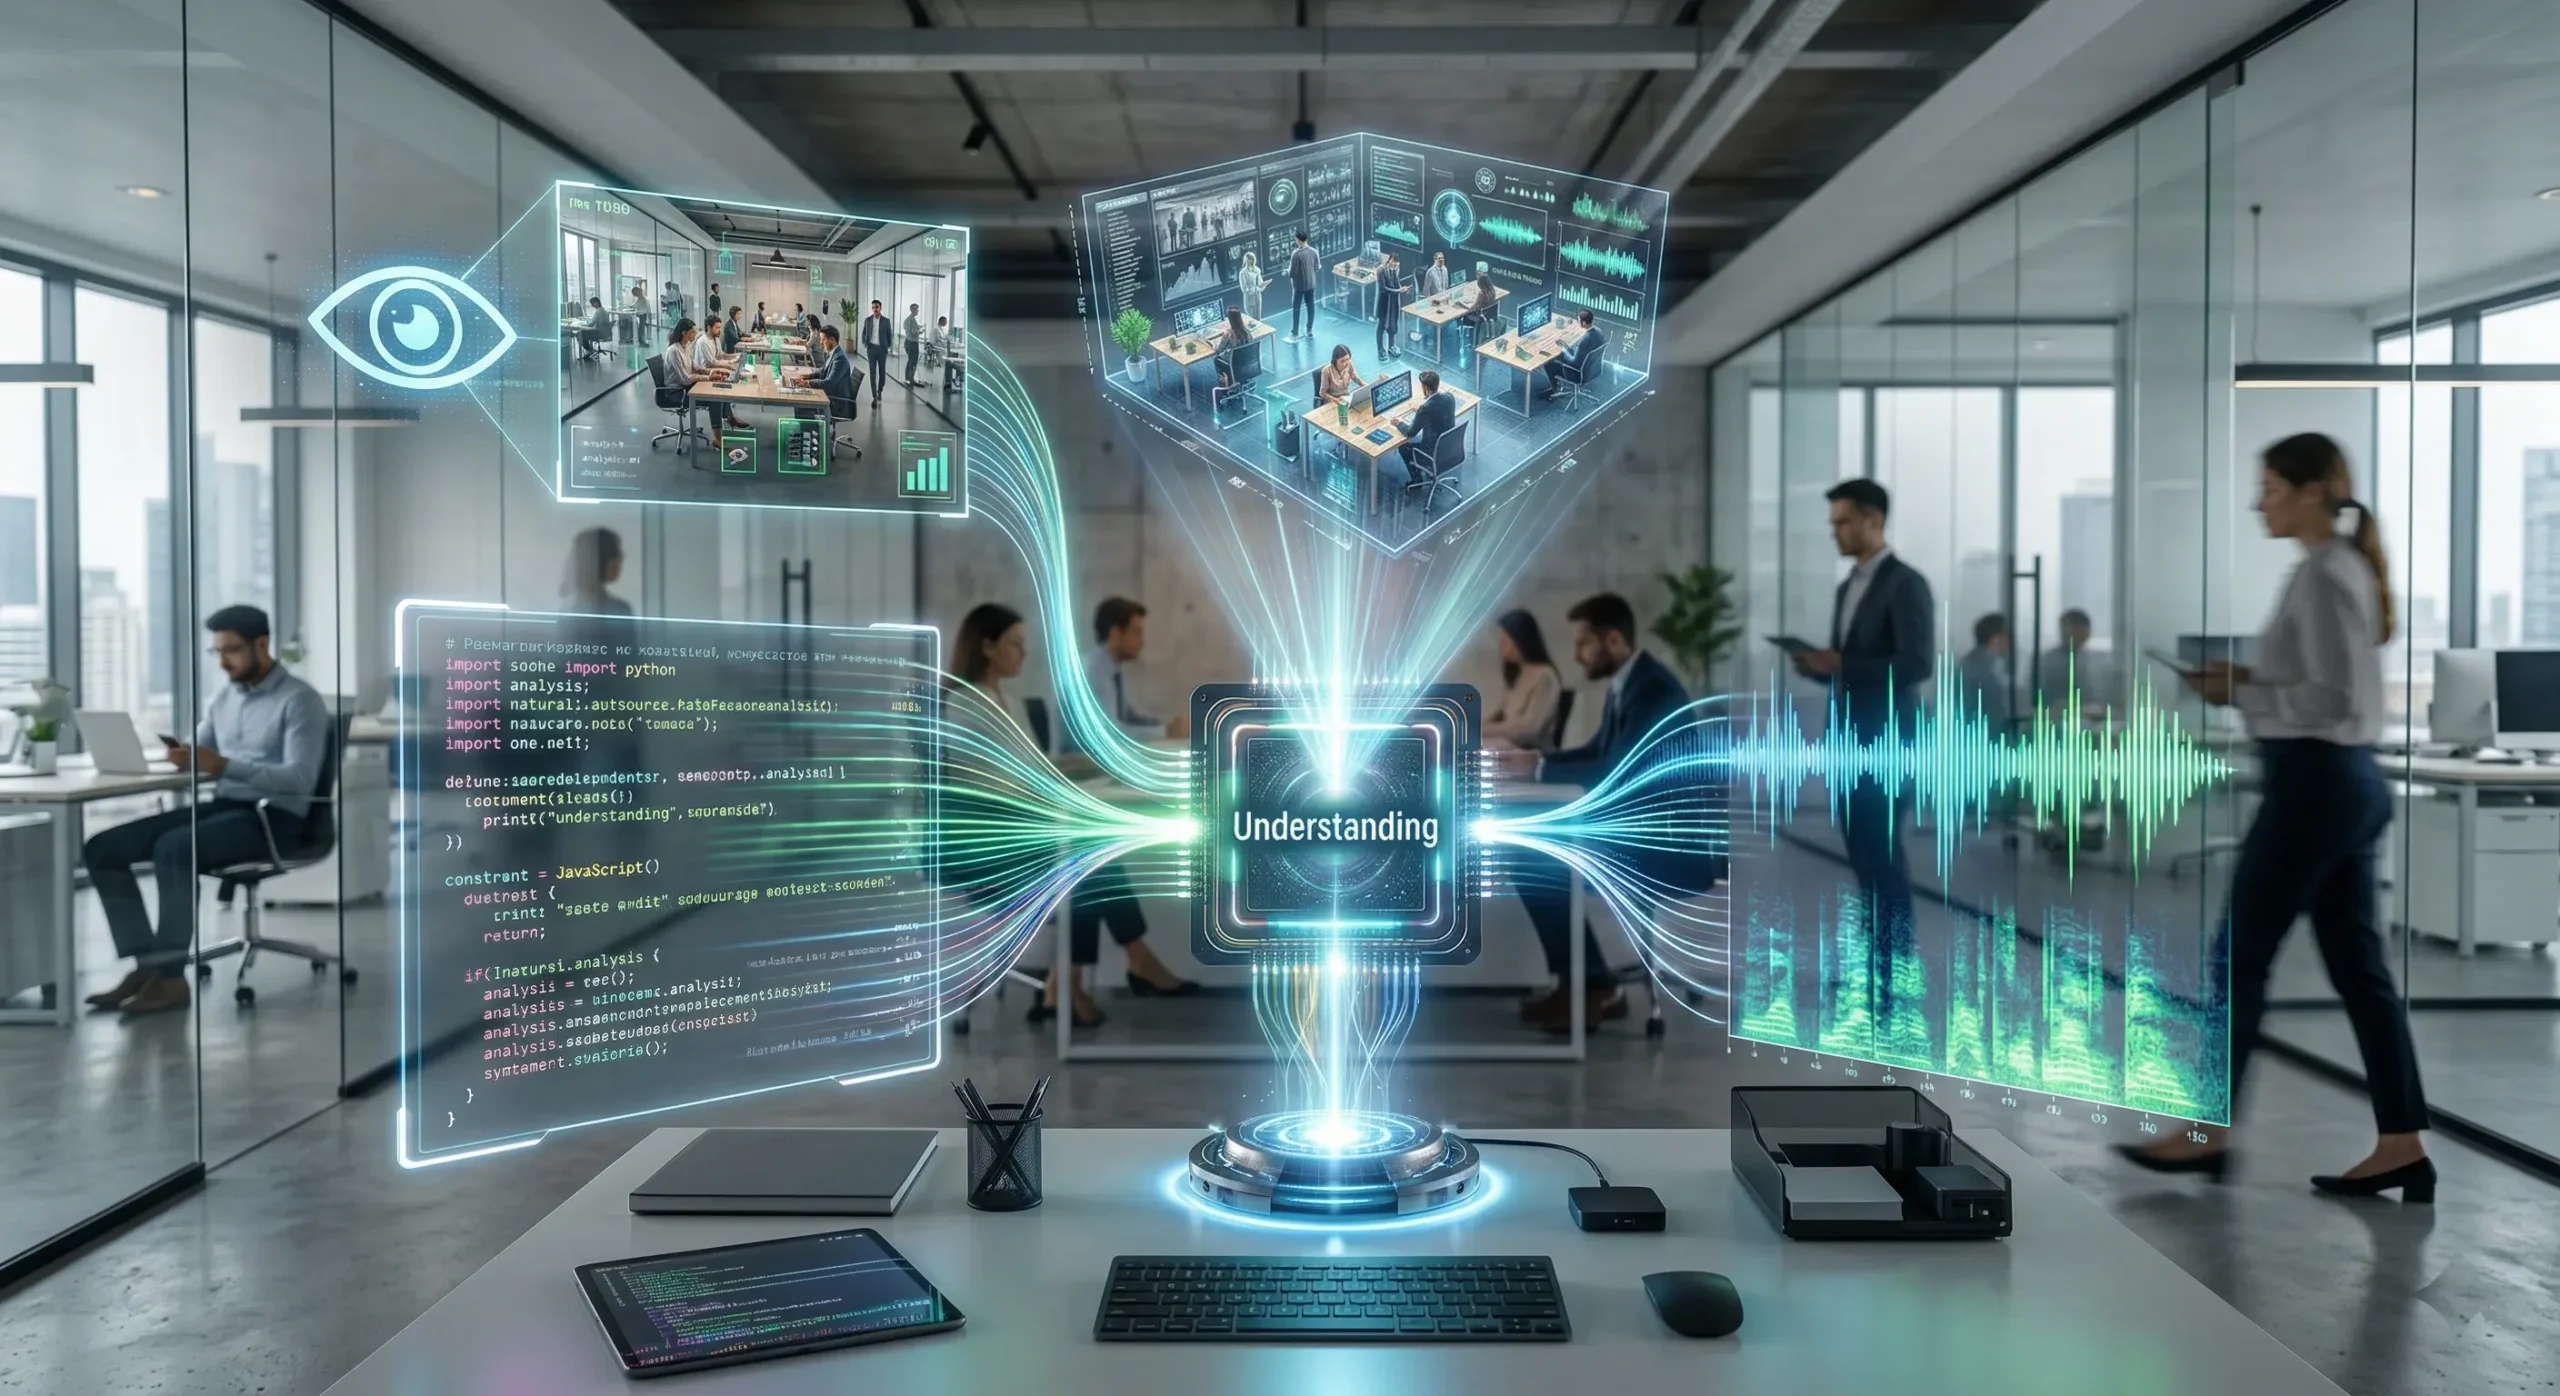
AI-ul multimodal din 2026 nu mai citește doar text. El vede imagini, ascultă sunete și analizează video. La Altanet Craiova considerăm că această schimbare transformă radical felul în care oamenii interacționează cu inteligența artificială. Nu mai este un instrument de răspuns la întrebări. Este un sistem care percepe lumea așa cum o percepem și noi.
Ce înseamnă „multimodal”?
Un model AI clasic procesează text. Îi scrii o întrebare și îți dă un răspuns scris. Simplu, dar limitat.
Un model AI multimodal procesează mai multe tipuri de informație simultan:
- Text: citește și scrie în orice limbă.
- Imagini: vede fotografii, grafice, desene și documente scanate.
- Audio: ascultă și transcrie vorbire, identifică sunete.
- Video: analizează clipuri, înțelege ce se întâmplă într-o scenă.
Fast Company a declarat 2026 „anul AI multimodal”. Nu este o exagerare. Multimodalitatea a trecut de la un feature opțional la standardul minim așteptat de la orice model serios.
Cine sunt modelele multimodale de top în 2026?
Aproape toate modelele importante au devenit multimodale în acest an:
- MMaDA (8 miliarde de parametri): depășește simultan LLaMA-3-7B la raționament text și Stable Diffusion XL la generare de imagini. Totul într-o singură arhitectură unificată.
- EBind: leagă patru modalități – imagine, video, audio și obiecte 3D – într-un singur model. Depășește modele de 4-17 ori mai mari în testele de referință.
- GPT-5, Claude Opus 4.6, Gemini 3.1 Pro: toate procesează text, imagini și audio nativ. Video-ul este în curs de integrare completă.
- Google Veo 3.1: generează și editează video cu control asupra sunetului și obiectelor din scenă.
Unde este deja folosit AI-ul multimodal?
Graficul de mai jos arată principalele domenii de utilizare a AI-ului multimodal și nivelul lor de maturitate în 2026:
Utilizare matură
În creștere
Trei exemple concrete din viața de zi cu zi
Multimodalitatea nu este abstractă. Iată trei situații practice în care o întâlnești deja:
- Suport tehnic vizual: fotografiezi o eroare de pe ecranul calculatorului și trimiți poza către asistentul AI. El vede imaginea, identifică problema și îți explică soluția. Nu mai trebuie să descrii în cuvinte ce vezi pe ecran.
- Analiza unui contract scanat: scanezi un document PDF și îl trimiți modelului AI. El citește textul din imagine, identifică clauzele importante și îți semnalează potențialele riscuri.
- Traducere în timp real cu context vizual: filmezi un panou cu text într-o limbă străină. AI-ul vede imaginea, recunoaște textul și ți-l traduce instantaneu, ținând cont de contextul vizual din jur.
Ce urmează?
Până în 2027, estimările arată că AI-ul multimodal va înțelege contextual lumea fizică. Va combina date de la senzori, camere și microfoane într-un model unificat de înțelegere a realității. Roboții și dispozitivele inteligente vor percepe și reacționa la mediul lor la fel cum o face un om.
Dacă vrei să înțelegi cum poți folosi AI-ul multimodal în firma ta – pentru suport clienți, analiza documente sau control de calitate – echipa Altanet Craiova te poate ajuta cu soluții concrete. Intră pe pagina noastră de contact și hai să discutăm.
Acest articol face parte din seria Altanet despre tendințele AI în 2026. Articolul următor: AI Fizic și Robotică: Când roboții umanoizi încep primul lor job în fabrică. Vezi și ghidul complet al seriei.